从零手写 Transformer:用数字反转读懂多头注意力、因果 mask 与自回归生成
读 Transformer 时,最容易出现一种情况:公式认识,代码也能运行,但一问“这个位置到底在预测哪个 token”,就开始犹豫。
这篇文章把一次已经完成的实验重新拆开:从长度为 6 的数字序列反转出发,手写多头自注意力,搭建两层 decoder-only Transformer,再用真实训练结果和注意力热图检查自己的理解。
阅读只需要基本 Python、矩阵乘法和一点导数概念。PyTorch 不熟悉也没关系,下面会把关键张量的形状写出来。建议分三遍读:第一遍追踪一条样本,第二遍对照代码看形状,第三遍再看消融结果。
正文中的数据小例子和注意力类可以用来动手观察;Block、完整模型和训练循环的片段会标明其所在位置。完整实验按随文 notebook 的顺序运行,避免把多个类里的 forward 当成独立函数依次粘贴。训练曲线、热图、表格都来自同一次最终实验记录。
先约定几个符号,后面遇到形状时可以回来看:
| 符号 | 含义 | 本实验的例子 |
|---|---|---|
| B | 一批样本的数量,batch size | 正式训练 64,演示可用 1 或 2 |
| T | 本次前向实际输入的 token 数 | 训练 14;生成从 8 逐步增加到 14 |
| D | 每个 token 的隐藏向量维度 | 64 |
| H | 注意力头数 | 完整模型 4,单头消融 1 |
| Dh 或 $d_h$ | 每个头的维度,D/H | 四头时 16,单头时 64 |
位置编号统一从 0 开始。方括号里的维度按实际顺序排列,例如 [B,H,T,Dh]。@ 做矩阵乘法,使用最后两个维度参与计算;前面的 batch 和 head 维按广播规则配对。reshape 中的 -1 让 PyTorch 推算这一维大小,dim=-1 则表示最后一维,两处含义不同。
一、先明确我们究竟要让模型做什么
给模型六个数字,要求它按相反顺序输出。例如:
输入题目:3 1 4 2 0 5
正确答案:5 0 2 4 1 3
这里没有自然语言分词,也没有预训练模型。数字 0–9 本身就是 token,再加入三个特殊符号:
| 符号 | ID | 含义 |
|---|---|---|
| 数字 0–9 | 0–9 | 原题和答案里的数字 |
<BOS> |
10 | 一条样本的开始 |
<SEP> |
11 | 题目和答案的分隔位置 |
<EOS> |
12 | 答案结束 |
一条完整样本写成:
<BOS> 3 1 4 2 0 5 <SEP> 5 0 2 4 1 3 <EOS>
词表大小是 13,完整样本长度是 15。我们使用同一条 token 序列同时容纳题目和答案,模型通过自注意力读取序列里的信息。这就是本实验采用 decoder-only 结构的方式,不需要再增加一个独立 encoder 或 cross-attention 模块。
实验配置先固定下来:
| 项目 | 配置 |
|---|---|
| 数据 | 训练 4096、验证 256、测试 512 条,无重复、无交集 |
| 随机种子 | 模型和数据生成 42,训练抽样 142 |
| 序列 | 固定长度 6,数字范围 0–9,保留前导零 |
| 模型 | 2 层,隐藏维度 64,4 头,前馈维度 128 |
| 位置编码 | 可学习的绝对位置 embedding |
| Block | Pre-LayerNorm、残差连接、GELU,dropout 为 0 |
| 训练 | Adam,学习率 0.003,batch size 64,梯度裁剪 1 |
| 最终运行 | Colab 免费版 Tesla T4,每组 600 步 |
| 参数量 | 每组 69,709 |
本次环境记录为 Python 3.13.16、PyTorch 2.11.0+cu130、NumPy 2.1.3、Matplotlib 3.10.0。这些是实验快照,不表示复现时必须安装完全相同的版本。
二、最关键的一步:输入和标签为什么要错开
2.1 每个位置预测下一个 token
模型不是一次接收题目后直接返回一个六位数组。训练时,它在每个位置输出一个包含 13 个分数的向量,用来预测下一个 token。
下面先只构造一条样本。这个小例子不训练模型,目的是把输入和标签打印清楚:
import math
import torch
import torch.nn as nn
import torch.nn.functional as F

SEQ_LEN = 6
BOS, SEP, EOS = 10, 11, 12
PROMPT_LEN = SEQ_LEN + 2

def encode_sequence(sequence):
    digits = list(sequence)
    return [BOS] + digits + [SEP] + digits[::-1] + [EOS]

sequences = [(3, 1, 4, 2, 0, 5)]  # 这里只演示一条,B=1
full = torch.tensor([encode_sequence(s) for s in sequences],
                    dtype=torch.long)
inputs = full[:, :-1].contiguous()
labels = full[:, 1:].clone()
labels[:, :PROMPT_LEN - 1] = -100
print(inputs.tolist())
print(labels.tolist())
对应输出应当是:
[[10, 3, 1, 4, 2, 0, 5, 11, 5, 0, 2, 4, 1, 3]]
[[-100, -100, -100, -100, -100, -100, -100, 5, 0, 2, 4, 1, 3, 12]]
PROMPT_LEN=8,即一个 BOS、六个数字和一个 SEP。inputs 和 labels 都是 [B,14]。
把上一节的例子逐位置展开:
| 输入位置 i | 输入 token | 该位置要预测的下一个 token | 是否计入 loss |
|---|---|---|---|
| 0 | <BOS> |
3 | 否 |
| 1 | 3 | 1 | 否 |
| 2 | 1 | 4 | 否 |
| 3 | 4 | 2 | 否 |
| 4 | 2 | 0 | 否 |
| 5 | 0 | 5 | 否 |
| 6 | 5 | <SEP> |
否 |
| 7 | <SEP> |
5,第一个答案数字 | 是 |
| 8 | 5 | 0 | 是 |
| 9 | 0 | 2 | 是 |
| 10 | 2 | 4 | 是 |
| 11 | 4 | 1 | 是 |
| 12 | 1 | 3,第六个答案数字 | 是 |
| 13 | 3 | <EOS> |
是 |
位置 7 的 SEP 预测第一个答案数字,位置 13 的最后一个答案数字预测 EOS。 注意力图和生成代码都要遵守这个偏移关系。
如果误把位置 8 的输入数字当成“负责预测第一个答案的位置”,后面的热图解释就会整体错一格。
训练时,预测第二个答案所用的前一个答案是真实数字,这叫教师强制(teacher forcing)。测试时则要使用模型自己上一步生成的数字。两者的区别就在这里。
虽然训练时把整条输入一起送进模型,因果 mask 会限制每一行只能读取当前及以前的位置。因此,各行的“预测下一个 token”可以并行计算,并不等于每行都能看到完整答案。
2.2 为什么题目部分的标签设为 -100
我们关心的是反转题目,没有要求模型学习随机题目本身如何接续。因此,只监督六个答案数字和 EOS,共七个目标。
下面先看损失函数的调用接口:logits 是完整模型稍后产生的输出,现在还没有计算出来。这段先读懂形状,等模型定义后再对照 notebook 中的 answer_loss 调用。
loss = F.cross_entropy(
    logits.reshape(-1, 13),
    labels.reshape(-1),
    ignore_index=-100,
)
logits 的形状是 [B,14,13],展平后变成 [B*14,13];标签展平为 [B*14]。被标为 -100 的位置不参与这个平均值,也不产生对应的直接分类损失梯度。
对这份定长数据,先把 logits 转成概率,记作 $p_{b,i,c}$:它表示样本 b、输入位置 i 预测下一个 token 为类别 c 的概率。平均交叉熵可写成:
\[\mathcal{L}=-\frac{1}{7B}\sum_{b=0}^{B-1}\sum_{r=0}^{6} \log p_{b,\,7+r,\,\mathrm{labels}_{b,7+r}}.\]这里转概率是沿 13 个输出类别归一化;后面的注意力 softmax 则沿 T 个 key 位置归一化。它们作用于不同张量,不能混为一谈。
内层正好取 query 位置 7–13 的七个正确标签:六个数字和 EOS。给正确 token 的概率越低,这一项的损失越大。这里只是在解释公式,实际代码仍直接把 logits 交给交叉熵函数。
例如,假设一条样本的七个正确标签都得到 0.5 的预测概率,那么每项损失都是 -log(0.5)≈0.693,平均 loss 仍是约 0.693,不是把七项相加后的 4.852。这里的 log 是自然对数。
因此,在没有类别加权、每条样本恰好七个有效标签的本实验中,loss 的分母相当于 B*7,不是 B*14。CrossEntropyLoss 接收未归一化的分类分数,直接输入 logits 即可;不需要先手动 softmax。PyTorch 官方说明
这里还有一个容易混淆的地方:题目位置不计算分类 loss,不代表题目 embedding 不会训练。 答案位置的注意力会读取题目位置的 K、V,答案损失仍然可以沿这条路径更新相关参数。
2.3 loss mask 和因果 mask 各管什么
| 机制 | 修改什么 | 解决的问题 |
|---|---|---|
| loss mask | 把部分标签设为 -100 |
哪些预测需要接受监督 |
| 因果 mask | 把注意力中的未来分数设为负无穷 | 每个位置能读取哪些位置 |
只做 loss mask,不能阻止答案泄漏;只做因果 mask,也不会自动忽略题目部分的损失。两个机制需要分别实现。
三、从 token ID 到隐藏向量
数字 ID 只是一个离散编号,不能直接拿 ID 大小表示语义距离。模型先通过 embedding 查表,得到 64 维向量。以下是模型方法中的节选,self.token_embedding 等对象会在完整模型的构造函数里创建;先对照后面的形状表阅读即可:
positions = torch.arange(seq_len, device=token_ids.device)
x = (
    self.token_embedding(token_ids)
    + self.position_embedding(positions).unsqueeze(0)
)
| 张量 | 形状 |
|---|---|
| token ID | [B,T] |
| token embedding | [B,T,64] |
| position embedding | [T,64] |
| 扩展 batch 维后的 position embedding | [1,T,64] |
| 相加后的隐藏表示 | [B,T,64] |
同一个数字 2 出现在不同位置时,token embedding 相同,但位置 embedding 不同。后续网络因此有机会区分“第一个 2”和“第三个 2”。
这对反转任务非常直接:模型需要知道第一个答案应当读取原题的第六个位置,而不能只根据数字内容猜测。
本实验使用的是可学习的绝对位置向量,没有采用正弦位置编码、RoPE 或相对位置编码。位置表预留了 15 个位置,但训练输入实际为 14 个 token,生成最后的 EOS 后也不再进行下一次前向。预留的位置表大小不代表模型学会了任意长度的反转。
四、单头注意力:Q、K、V 分别做什么
4.1 三组投影来自同一份输入
先固定一条样本、只看一个头。设输入 X 为 [T,D],这个头把它投影成 [T,Dh] 的 Q、K、V。三者由同一组隐藏表示产生,但使用不同参数;单头投影矩阵的数学形状为 [D,Dh]:
数学公式按 XW 书写;PyTorch 的 nn.Linear 把 weight 存成 [输出维度,输入维度],内部相当于 X @ weight.T + bias。这只是存储约定的差别。Linear 官方说明
可以先这样理解它们的分工:
- Q,查询向量: 当前位置拿什么特征去寻找相关信息。
- K,键向量: 各个位置拿什么特征参与匹配。
- V,值向量: 匹配完成后,实际汇总的内容。
Q 和 K 决定“从哪里读”,V 决定“读到什么”。这只是帮助理解的分工,具体特征由训练学习,不是我们手工指定“某一维专门识别某个数字”。
4.2 QK 转置得到的是位置之间的分数
对于一个头:
\[S_{ij}=\frac{q_i\cdot k_j}{\sqrt{d_h}}.\]行 i 是发起查询的位置,列 j 是被读取的位置。所以长度为 T 的序列会产生一个 T×T 分数矩阵。
除以每头维度的平方根,是为了控制点积的尺度。在分量近似独立、尺度相近的简化分析下,维度越大,点积的波动通常越大;未经缩放的较大分数更容易让 softmax 变得尖锐。它不是在代码里“凭经验随便除一个数”。缩放点积和多头结构的来源可参阅 Attention Is All You Need。
4.3 沿 key 方向做 softmax
\[A_{ij}=\frac{\exp(S_{ij}+M_{ij})}{\sum_k\exp(S_{ik}+M_{ik})}, \qquad O_i=\sum_j A_{ij}V_j.\]每个 query 对所有 key 的权重之和为 1。最后的输出是 V 的加权和。
因此,在注意力核心函数内部,softmax 应当沿最后一个维度,即 key 维度计算:
weights = torch.softmax(scores, dim=-1)
output = weights @ v
如果沿 query 维归一化,即使代码可以运行,含义也已经变成另一种计算。
五、因果 mask:把“不能看到未来”落实到矩阵里
训练输入里包含六个正确答案数字,但不包含末尾 EOS。如果允许位置 7 的 SEP 读取位置 8,它就能直接看到自己要预测的第一个答案。
我们要求位置 i 只能读取 j<=i 的位置:
以五个位置为例,允许读取的位置如下:
              key →
              0  1  2  3  4
query  0      ✓  ×  ×  ×  ×
  ↓    1      ✓  ✓  ×  ×  ×
       2      ✓  ✓  ✓  ×  ×
       3      ✓  ✓  ✓  ✓  ×
       4      ✓  ✓  ✓  ✓  ✓
注意,对角线可以读取。输入位置 i 的当前 token 本来就已知,我们要预测的是 i+1,所以不需要屏蔽当前位置。
完整的注意力核心只有几步:
def scaled_dot_product_attention_manual(q, k, v, causal=True):
    # q/k/v: [B,H,T,Dh]
    d_k = q.size(-1)
    scores = (q @ k.transpose(-2, -1)) / math.sqrt(d_k)
    # scores: [B,H,T,T]

    if causal:
        blocked = torch.ones(
            scores.shape[-2:],
            dtype=torch.bool,
            device=q.device,
        ).triu(diagonal=1)
        scores = scores.masked_fill(blocked, float("-inf"))

    weights = torch.softmax(scores, dim=-1)
    output = weights @ v
    return output, weights
这里的二维 mask 会广播到所有 batch 和所有头,True 代表屏蔽。
为什么在 softmax 前填负无穷? 因为 exp(-∞)=0,被屏蔽的位置会得到零权重,其余可见位置仍然归一化。如果先 softmax 再把未来权重清零,剩余权重的和通常不再是 1。
也不要把所有分数都填成负无穷,否则这一行无法得到正常的归一化结果。当前实现保留对角线,每行至少有一个可读位置。
一个可以手算的小例子
先把序列长度和每头维度都设为 2,取 Q=K=单位矩阵,V 的两行为 [10,0] 和 [0,20]。这是便于计算的示意,不是训练后的真实热图。
位置 0:原始分数 [1/√2, 0]
        因果 mask 后 [1/√2, -∞] → 权重 [1, 0] → 输出 [10, 0]

位置 1:原始分数 [0, 1/√2],两个位置都已可见
        softmax 后约为 [0.330, 0.670]
        输出 ≈ 0.330×[10,0] + 0.670×[0,20] ≈ [3.302,13.395]
注意力输出仍然是连续向量。它没有直接输出一个数字 token,后续还需要完整模型的其他子层及分类层产生词表分数。
六、多头注意力:64 维怎样变成四个 16 维头
6.1 先投影,再拆头
设 D=64、H=4,每头维度为 Dh=D/H=16。
X                         [B,T,64]
Q/K/V 线性投影             [B,T,64]
reshape                   [B,T,4,16]
transpose                 [B,4,T,16]
Q @ K.transpose(-2,-1)    [B,4,T,T]
softmax 后 @ V            [B,4,T,16]
transpose + 拼接           [B,T,64]
输出投影                   [B,T,64]
这里不是把原始输入的 64 维直接分配成四份、让每个头只看四分之一输入。前面已经做过全维线性投影,每个头都可以利用输入的全部 64 维特征,只是最终用 16 维子空间计算匹配。
先单独看拆头方法;下一小节会把它放回完整类中:
def _split_heads(self, tensor):
    batch_size, seq_len, _ = tensor.shape
    return tensor.reshape(
        batch_size, seq_len, self.num_heads, self.head_dim
    ).transpose(1, 2)
先把头维放进来,再把头维移到序列维之前,才能让后面的矩阵乘法分别处理各个头。这里的 64 维总投影,可以看作把四组 [64,16] 的单头投影并排存放;拆头后,每个头对应上一节公式里的一组 Q、K、V。
6.2 拼接不能写成求平均
把初始化、拆头和拼接放回同一个类里,完整注意力模块如下。它沿用实跑 notebook 的实现,可以接在第五节的注意力核心函数之后:
class ManualMultiHeadSelfAttention(nn.Module):
    def __init__(self, d_model=64, num_heads=4, causal=True):
        super().__init__()
        if d_model <= 0 or num_heads <= 0 or d_model % num_heads != 0:
            raise ValueError("d_model must be positive and divisible by num_heads")
        self.d_model = d_model
        self.num_heads = num_heads
        self.head_dim = d_model // num_heads
        self.causal = causal
        self.q_proj = nn.Linear(d_model, d_model)
        self.k_proj = nn.Linear(d_model, d_model)
        self.v_proj = nn.Linear(d_model, d_model)
        self.out_proj = nn.Linear(d_model, d_model)

    def _split_heads(self, tensor):
        batch_size, seq_len, _ = tensor.shape
        # [B,T,D] -> [B,T,H,Dh] -> [B,H,T,Dh]
        return tensor.reshape(batch_size, seq_len, self.num_heads,
                              self.head_dim).transpose(1, 2)

    def forward(self, x, causal=None):
        batch_size, seq_len, _ = x.shape
        use_causal = self.causal if causal is None else causal
        q = self._split_heads(self.q_proj(x))
        k = self._split_heads(self.k_proj(x))
        v = self._split_heads(self.v_proj(x))
        head_outputs, weights = scaled_dot_product_attention_manual(
            q, k, v, causal=use_causal)
        # 先交换维度,再拼接各个头;contiguous 使内存布局适合 view
        merged = head_outputs.transpose(1, 2).contiguous().view(
            batch_size, seq_len, self.d_model)
        output = self.out_proj(merged)
        # 返回每个头的权重 [B,H,T,T],保留层/头可视化所需的信息
        return output, weights
transpose 调整维度顺序,contiguous() 让内存布局适合后续 view。也可以采用与布局兼容的 reshape 写法,但需要清楚元素排列是否正确。
拼接之后再做输出投影:
\[\operatorname{MultiHead}(X) =\operatorname{Concat}(\operatorname{head}_1,\ldots,\operatorname{head}_H)W_O+b_O.\]求平均会提前丢失头之间的区分,不能代替这里的拼接。
为了后面画图,我们保留完整权重 [B,H,T,T],不在模块返回时把头平均掉。上面类中的四组投影均为 nn.Linear(64,64)。这四组分别是 Q、K、V 和输出投影,不是“四个注意力头各有一个投影”。每组总投影里都包含各头自己的参数分块。
6.3 在训练之前就能检查的东西
运行上面的完整注意力类后,先用一批随机向量做小测试。这里的向量只用于检查实现,不是数字题目本身:
torch.manual_seed(42)
attention_demo = ManualMultiHeadSelfAttention(64, 4, causal=True)
embedding_demo = torch.randn(2, 14, 64)
with torch.no_grad():
    output, weights = attention_demo(embedding_demo)
assert output.shape == (2, 14, 64)
assert weights.shape == (2, 4, 14, 14)
assert torch.allclose(
    weights.sum(-1),
    torch.ones_like(weights.sum(-1)),
    atol=1e-6,
)
future = torch.ones(14, 14, dtype=torch.bool,
                    device=weights.device).triu(1)
assert torch.count_nonzero(weights[:, :, future]) == 0
这些变量对应一个 batch size 为 2 的小测试,不是把整个训练集都放进这里。
更强的检查是:只改动未来 token,因果模型前面位置的输出应保持不变。这样可以检查 mask 有没有漏传到某一层。实验还把同一组参数复制到官方 nn.MultiheadAttention 做数值对照;官方模块只出现在验证里,实际训练使用手写实现。
七、注意力之外,Transformer Block 还做了什么
模型整体的数据流如下。图中展开的是第一个 Block,第二个 Block 重复相同结构,但使用另一组独立参数。每条残差路径都保留 [B,T,64] 的形状。
下面是 TransformerBlock.forward 的方法节选,需要放在对应类中。self.norm1、self.norm2、self.attention 和 self.ffn 由类的构造函数创建;完整定义见 notebook 第 4A 步:
def forward(self, x, causal=None):
    attention_output, weights = self.attention(
        self.norm1(x), causal=causal
    )
    x = x + self.residual_dropout(attention_output)
    x = x + self.residual_dropout(self.ffn(self.norm2(x)))
    return x, weights
对应关系可写成:
\[u=x+\operatorname{Attention}(\operatorname{LN}_1(x)), \qquad x_{\mathrm{out}}=u+\operatorname{FFN}(\operatorname{LN}_2(u)).\]这里的 u 和 $x_{\mathrm{out}}$ 都是 [B,T,64] 的隐藏表示。本实验 dropout 为 0,因此公式省略了代码中的 dropout 调用。各个部件分别负责:
| 部件 | 在这里负责什么 |
|---|---|
| 位置 embedding | 提供顺序和绝对位置的信息 |
| 注意力 | 在不同 token 位置之间汇总信息 |
| FFN | 对每个位置分别做非线性特征变换 |
| 残差连接 | 保留已有表示,并提供直接的梯度传播路径 |
| LayerNorm | 对每个位置的隐藏特征进行归一化,控制输入尺度 |
| 最后的分类层 | 把 64 维表示映射到 13 个 token 的分数 |
LayerNorm(64) 在这里沿最后的 64 维特征计算,不是沿 batch 维,也不是把整条 14-token 序列混成一个均值。LayerNorm 官方说明
前馈网络为 Linear(64,128) → GELU → Linear(128,64)。它在各位置共享同一组参数,但不会直接混合不同位置的信息。
Pre-LN 表示归一化放在子层之前。它与把 LN 放在残差相加之后的 Post-LN 有区别;本实验没有把两种写法混用。关于归一化位置与优化稳定性的分析,可以进一步阅读 On Layer Normalization in the Transformer Architecture。这篇论文讨论的是一般结构性质,不是本次实验的额外消融结果。
完整模型构造后,还会统一把 Linear 和 Embedding 权重初始化为均值 0、标准差 0.02 的正态分布,并将 Linear 偏置置零。第六节随机向量小测试使用的是独立的注意力模块;正式训练由 make_model 按固定种子重新构造整个模型,所以小测试不会算进训练预算。
下面是 ToyTransformer.forward 的方法节选。构造函数中的 embedding、两个独立 Block、末尾 LayerNorm 和输出层都在 notebook 第 4A 步定义;这里展示它们如何连接:
def forward(self, token_ids, return_attention=False, causal=None):
    seq_len = token_ids.size(1)
    positions = torch.arange(seq_len, device=token_ids.device)
    x = (self.token_embedding(token_ids)
         + self.position_embedding(positions).unsqueeze(0))
    attention_maps = []
    for block in self.blocks:
        x, weights = block(x, causal=causal)
        if return_attention:
            attention_maps.append(weights)
    logits = self.lm_head(self.final_norm(x))
    return logits, attention_maps
最终 logits 是 [B,T,13]。它表示每个位置对“下一个 token”的分类分数,不是已经生成好的答案。
69,709 个参数是怎样算出来的
| 部件 | 参数量 |
|---|---|
| token embedding:13×64 | 832 |
| position embedding:15×64 | 960 |
| 两个 Block | 66,944 |
| 最终 LayerNorm | 128 |
| 输出分类层:64×13+13 | 845 |
| 合计 | 69,709 |
一个 Block 内,四组注意力投影为 4*(64*64+64)=16640;FFN 为 (64*128+128)+(128*64+64)=16576;两个 LayerNorm 共 2*(64+64)=256。所以单个 Block 是 33,472 个参数。
这个计算也解释了为什么后面的单头消融参数量没有减少。
八、训练:不要把“loss 在下降”和“真的会生成”混为一谈
8.1 一个更新步骤包含什么
以下片段位于 notebook 第 5B 步的 train_model 函数内部。current_model 是当前待训练模型,indices 来自预先保存的共享批次索引;完整函数会先创建 Adam 和训练数据张量:
optimizer.zero_grad(set_to_none=True)
logits, _ = current_model(train_inputs[indices])
loss = answer_loss(logits, train_labels[indices])
loss.backward()
torch.nn.utils.clip_grad_norm_(
    current_model.parameters(), 1.0, error_if_nonfinite=True
)
optimizer.step()
先清掉上一步梯度,再前向计算、求损失、反向传播,最后由 Adam 更新参数。backward() 计算梯度,step() 才真正修改参数。
这里采用默认的 L2 梯度范数,超过 1 时才整体缩小梯度,较小的梯度不会被放大到 1。它不会截断 loss;按整体范数缩放与逐元素截断梯度也是两种不同的操作。梯度范数裁剪官方说明
正式训练前,我们用独立的小模型预热并测速,再从种子 42 重新初始化正式模型,避免把测速的 20 步偷偷算进基准模型的训练。
为保证消融可比,提前用独立生成器保存 [600,64] 的训练抽样索引。三组模型在同一步看到完全相同的一批样本;分别创建优化器,从头训练。
8.2 为什么要记录完整训练集和验证集的 loss
单个 batch 的 loss 会受抽样影响。这里每 50 步在 eval() 和无梯度模式下遍历完整训练集、验证集,按有效目标总数计算平均交叉熵。
eval() 切换 Dropout、BatchNorm 等模块的工作模式,不会自动关闭梯度记录;no_grad() 则控制是否建立反向计算图。评估时同时使用二者,职责各不相同。本实验 dropout 为 0,但依然保留正确的评估调用方式。Module.eval 官方说明
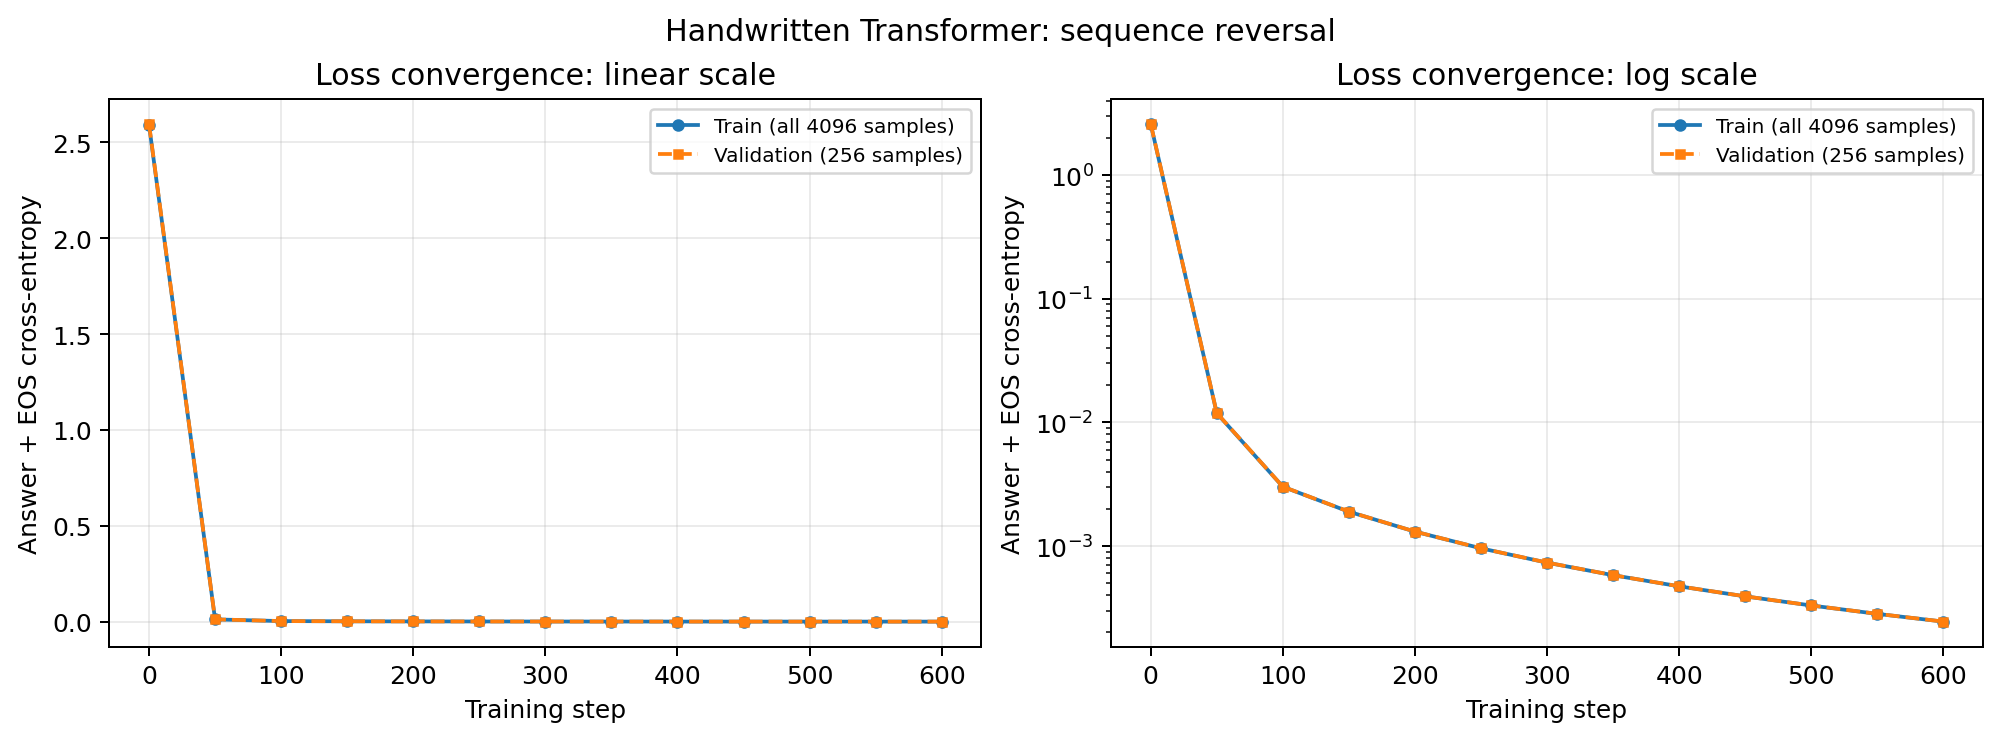
图 1:完整模型的训练与验证 loss。每个记录点都使用对应完整数据集;左侧为线性纵轴,右侧为对数纵轴。
完整模型的数值如下:
| 阶段 | 训练 loss | 验证 loss |
|---|---|---|
| 初始化 | 2.592788 | 2.596880 |
| 第 50 步 | 0.011877 | 0.011922 |
| 第 100 步 | 0.003019 | 0.003023 |
| 第 600 步 | 0.00024482 | 0.00024496 |
可以观察到:两条曲线在当前数据分布下都持续下降,最终数值接近。不过,曲线本身还没有回答“只给题目时,能否一步步生成正确答案”。这需要单独评估。
九、自回归生成:测试时必须把标准答案拿走
9.1 生成的第一步只输入八个 token
第 1 次前向:<BOS> 3 1 4 2 0 5 <SEP>       → 取最后位置,预测 5
第 2 次前向:<BOS> 3 1 4 2 0 5 <SEP> 5     → 预测 0
第 3 次前向:<BOS> 3 1 4 2 0 5 <SEP> 5 0   → 预测 2
……
第 7 次前向:<BOS> 3 1 4 2 0 5 <SEP> 5 0 2 4 1 3 → 预测 <EOS>
每次都取 logits[:, -1],因为最后一个输入位置负责预测接下来的 token。
@torch.no_grad()
def generate_answers(current_model, prompts):
    was_training = current_model.training
    current_model.eval()
    tokens = prompts.to(device).clone()
    assert tokens.size(1) == PROMPT_LEN
    assert (tokens[:, -1] == SEP).all()
    finished = torch.zeros(
        tokens.size(0), dtype=torch.bool, device=device
    )
    generated = []

    for _ in range(SEQ_LEN + 1):
        logits, _ = current_model(tokens)
        next_token = logits[:, -1].argmax(dim=-1)
        next_token = torch.where(
            finished, torch.full_like(next_token, EOS), next_token
        )
        generated.append(next_token)
        finished = finished | (next_token == EOS)
        tokens = torch.cat([tokens, next_token.unsqueeze(1)], dim=1)

    current_model.train(was_training)
    return torch.stack(generated, dim=1).cpu()
这是定长任务的批量生成写法:固定生成七步,已经输出 EOS 的行后续保持 EOS,方便统一张量形状。提前结束会导致后面缺少正确数字,在评分中计错。我们没有禁止输出 BOS、SEP 等符号,也没有用规则把结果强行改成六个数字。
这个小模型每一步都会重新计算整个已知前缀,没有实现 KV cache。短序列下,先让计算过程清楚比增加推理优化更适合学习。
9.2 两个准确率不能互相代替
数字 Token 准确率: 只比较六个数字位置,总计 512*6=3072 个数字。
整序列准确率: 六个数字全部正确,并且第七个输出是 EOS。只有这七个输出全部满足条件,一条样本才计为正确。
假设一条预测为 5 0 2 4 1 9 <EOS>,数字准确率是 5/6,但整序列得分是 0。如果六个数字全对却没有正确结束,数字准确率仍为 100%,整序列也要判错。
完整模型最终在独立测试集上得到:
| 指标 | 结果 |
|---|---|
| 数字 Token 准确率 | 3072/3072,100% |
| 整序列准确率,含正确 EOS | 512/512,100% |
| 教师强制测试 loss | 0.00024506 |
几个实际预测如下,编号沿用测试集固定顺序:
| 编号 | 题目 | 模型生成 |
|---|---|---|
| 0 | 0 2 8 2 2 3 |
3 2 2 8 2 0 <EOS> |
| 1 | 9 9 9 2 9 7 |
7 9 2 9 9 9 <EOS> |
| 2 | 7 6 2 5 3 8 |
8 3 5 2 6 7 <EOS> |
| 3 | 4 8 4 0 4 5 |
5 4 0 4 8 4 <EOS> |
| 4 | 9 8 8 7 8 0 |
0 8 7 8 8 9 <EOS> |
这份测试集没有错误样例。完整预测 CSV 保留了全部 512 条记录。100% 指的是这份定长、同分布测试集,不能外推为所有长度都能反转。
十、读注意力热图:先看坐标,再解释颜色
10.1 每个格子究竟表示什么
我们固定测试样本 0:
原题:0 2 8 2 2 3
答案:3 2 2 8 2 0 <EOS>
提取注意力时输入完整的教师强制序列,并保留两层、每层四头的矩阵,整体形状为 [2,4,14,14]。
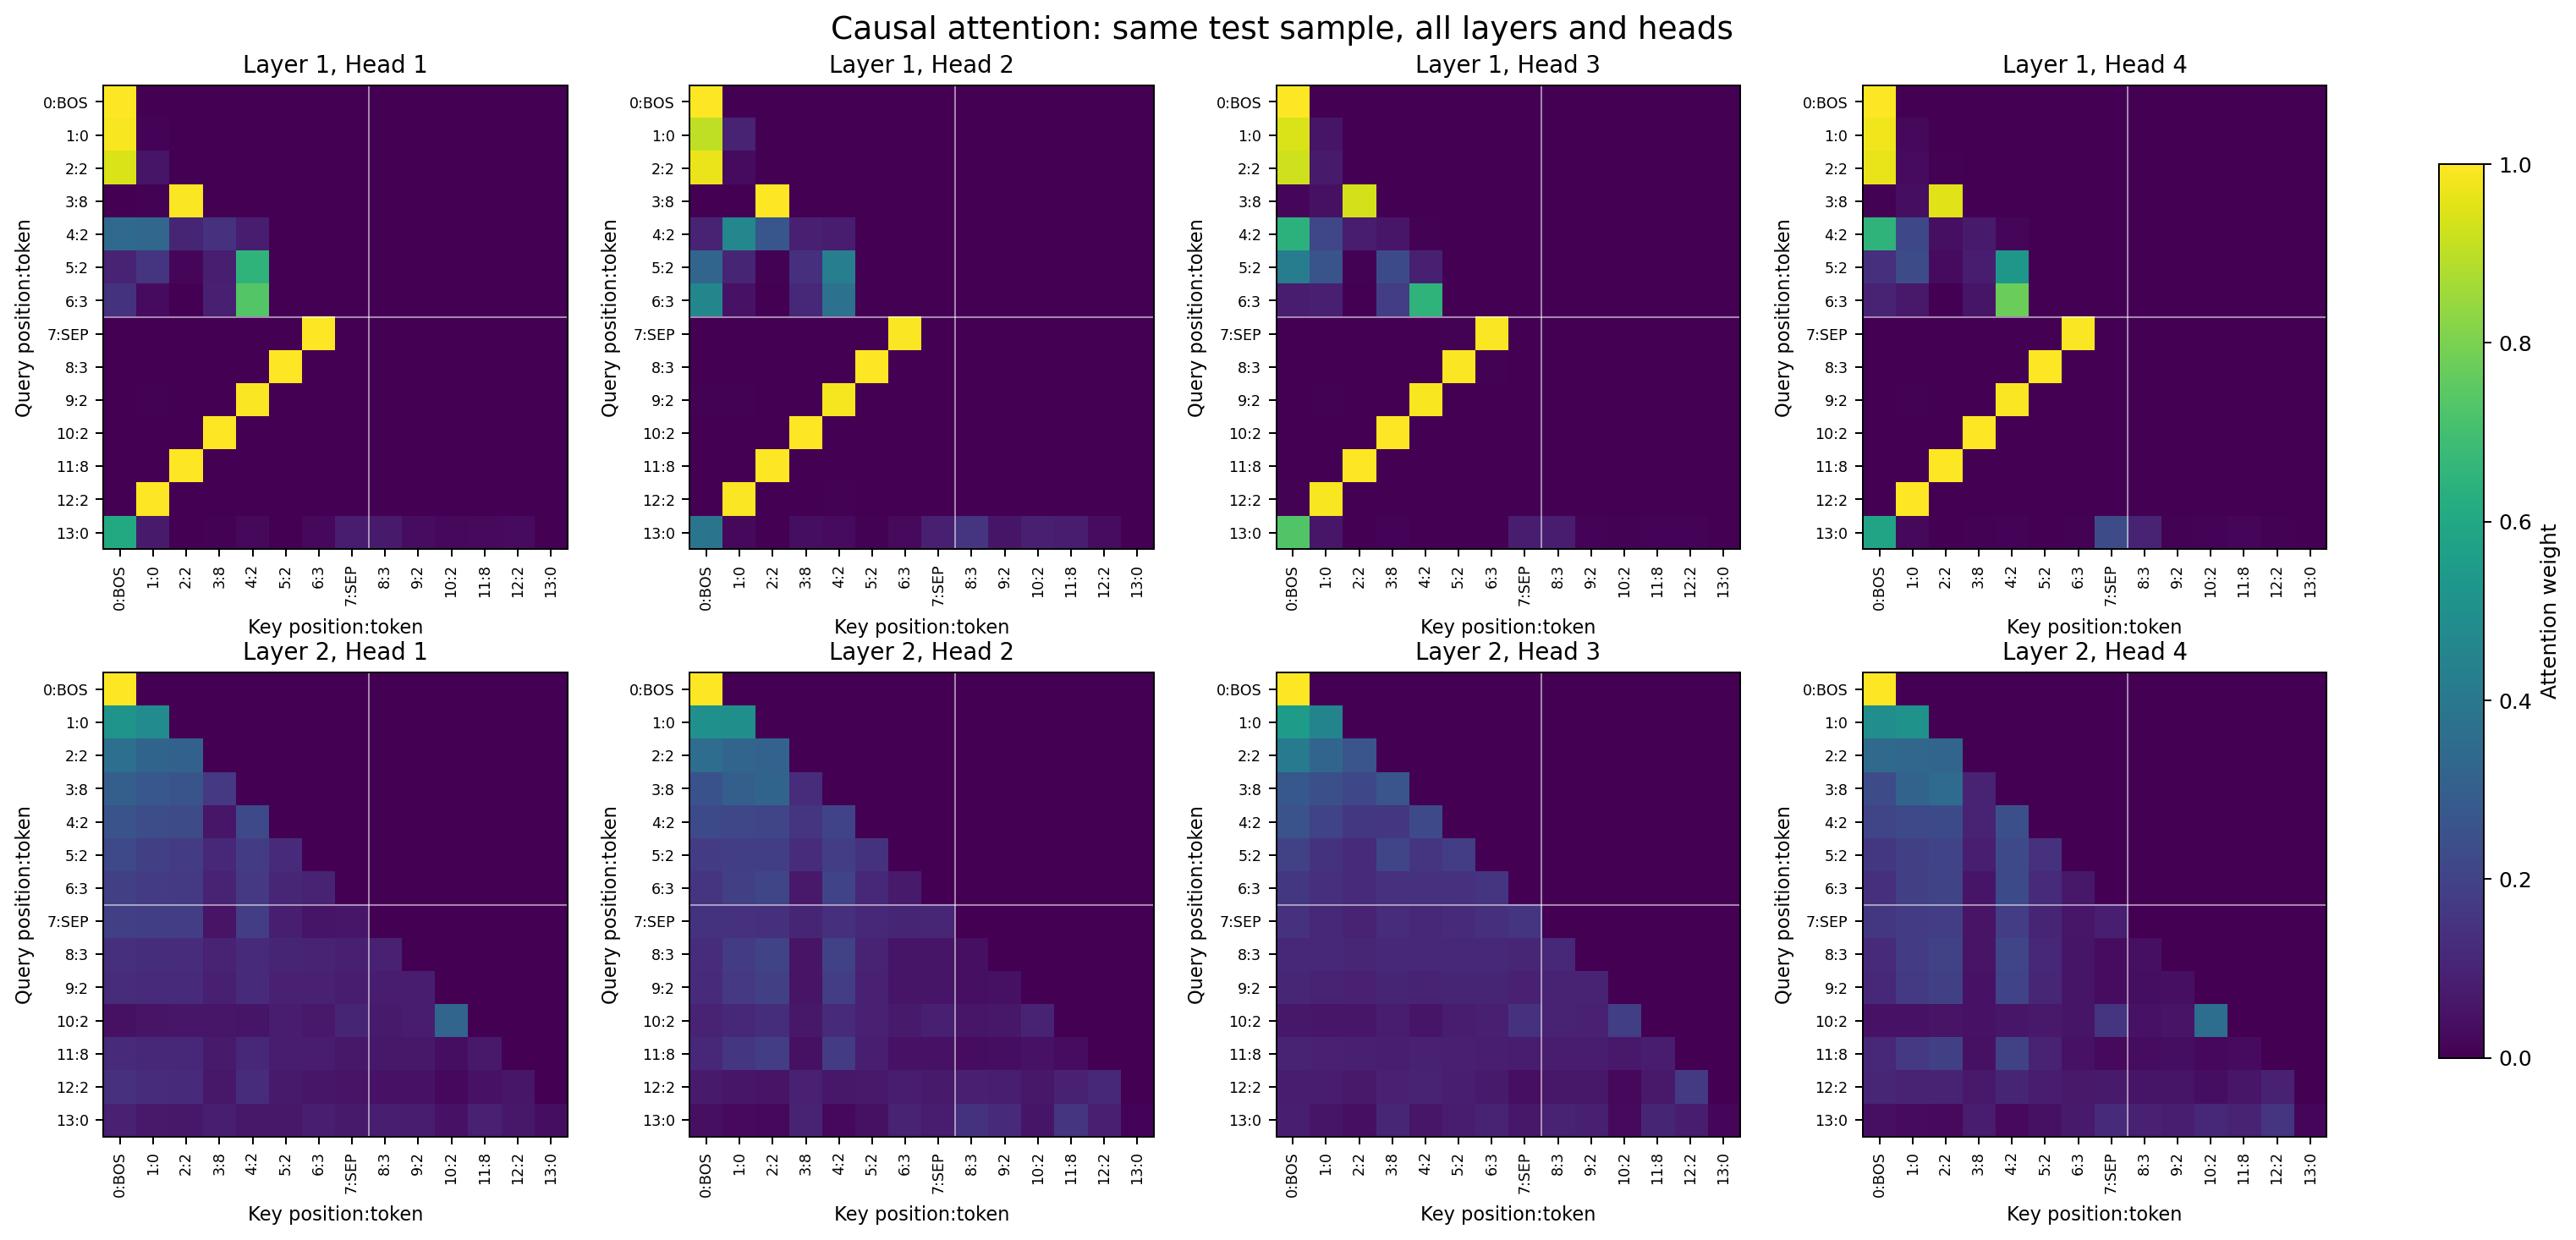
图 2:同一条样本的两层、四头注意力。纵轴为 query,横轴为 key;位置与 token 同时标注,颜色范围统一为 0–1。
图 2 中,两条白色分界线也有不同含义:横线位于 query 6 和 7 之间,下面开始是接受答案监督的 query;竖线位于 key 7 和 8 之间,右侧开始是答案 token 作为输入的位置。两条线差一个位置,正是输入与预测标签错位一格的结果。
读图时依次问三个问题:
- 当前是哪一层、哪一个头?
- 这一行 query 在预测哪个下一个 token?
- 颜色最深的列对应原题、已生成答案,还是未来位置?
上三角为零,首先反映的是 mask 的约束。不能仅凭这个三角形就说模型“学会了因果关系”。
10.2 反转对齐应该在哪些格子上出现
图 3 只截取六个答案数字的 query,不包含预测 EOS 的 query 13。这六个 query 位置是 7、8、9、10、11、12。对应的正确原题 key 位置是 6、5、4、3、2、1。
| 答案序号 | query 位置 | 预测数字 | 应读取的原题 key 位置 |
|---|---|---|---|
| 1 | 7,SEP | 3 | 6 |
| 2 | 8 | 2 | 5 |
| 3 | 9 | 2 | 4 |
| 4 | 10 | 8 | 3 |
| 5 | 11 | 2 | 2 |
| 6 | 12 | 0 | 1 |
三个不同位置都出现了数字 2,因此必须按位置区分,不能只看 token 字面值。
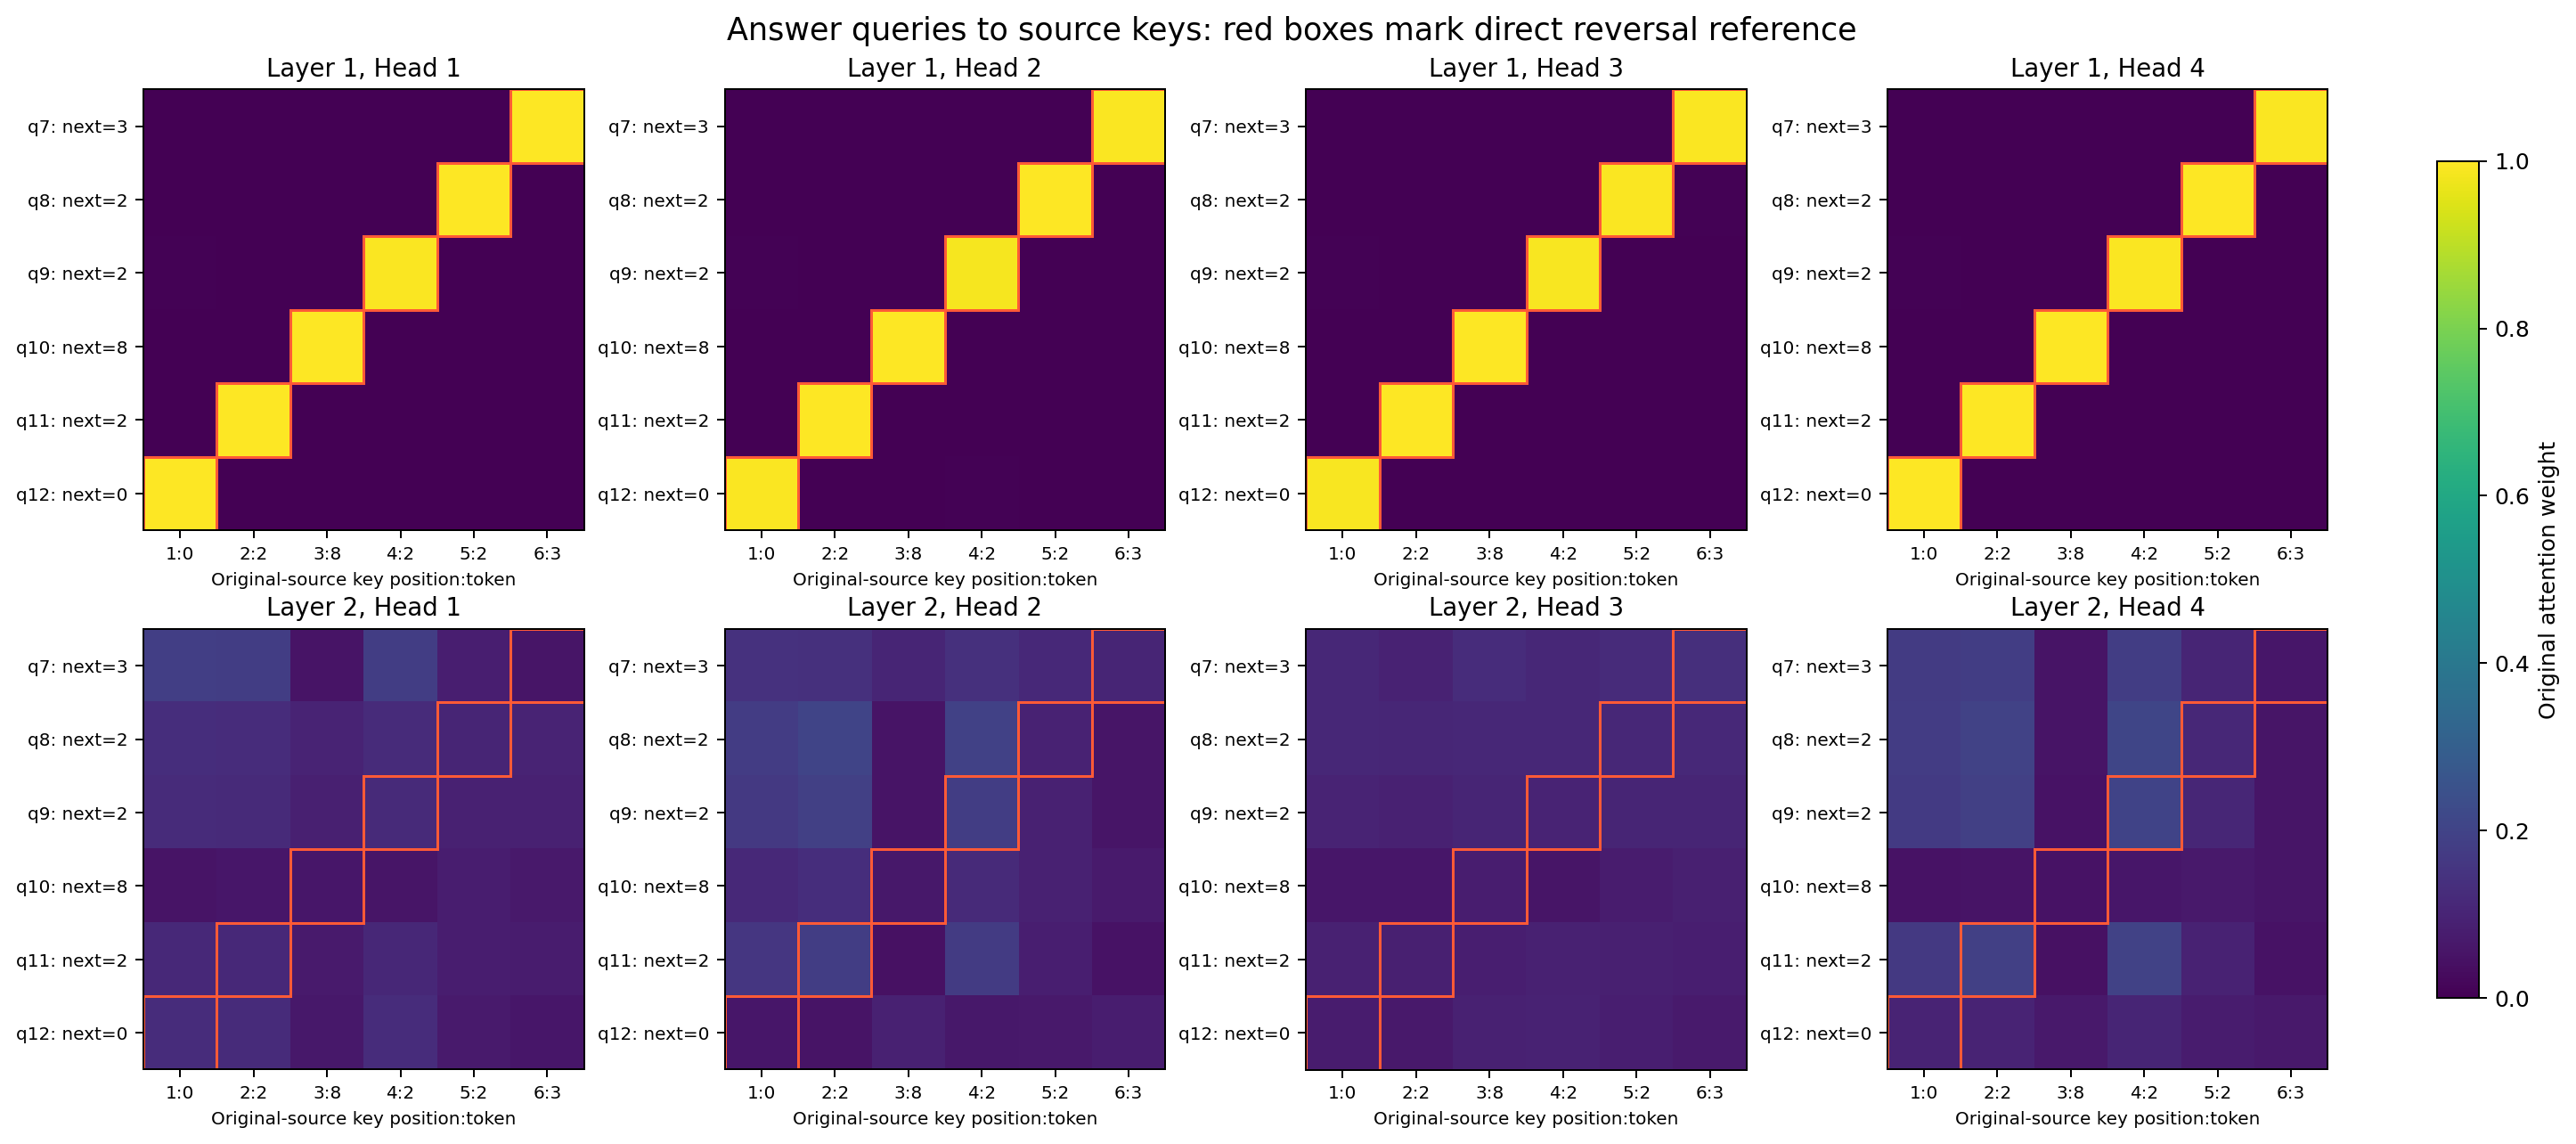
图 3:只截取答案 query 到六个原题 key 的局部区域。方框标出反转任务预期读取的位置,局部权重没有重新归一化。
局部图只是从原矩阵中取出这六行、六列,未对截取结果再做 softmax 或除以行和。因此局部图一行的总权重可以小于 1,剩余权重分配给了未展示的其他 key。
固定一层后,我们把四个头、六个预期位置上的权重做平均。下面 h 按 1 到 H 标记头,位置索引仍从 0 开始:
\[\text{alignment}=\frac{1}{H\cdot6} \sum_{h=1}^{H}\sum_{r=0}^{5}A_{h,7+r,6-r}.\]第一层的平均直接对齐权重为 99.64%,第二层为 10.71%。第一层四个头分别为 99.81%、99.51%、99.43%、99.79%;第二层四个头分别为 9.71%、11.46%、9.78%、11.90%。
这些百分比是注意力权重,不是预测准确率。
第一层在这个样本上形成清楚的反向位置读取模式。第二层的注意力更分散,但它接收的表示已经包含第一层汇总的信息,还有残差通路。不能因为第二层没有再次画出同样的反对角线,就认定第二层没有作用。
同样,几个头在一张图里看起来相似,也不能直接推出删掉其中某个头不会影响模型。真正判断某个头的因果作用,需要在控制其他条件的实验里验证。
十一、关闭 mask:固定权重的机制比较
先固定已经用因果 mask 训练好的完整模型,只在前向时切换所有层的 mask。这里不更新任何参数。
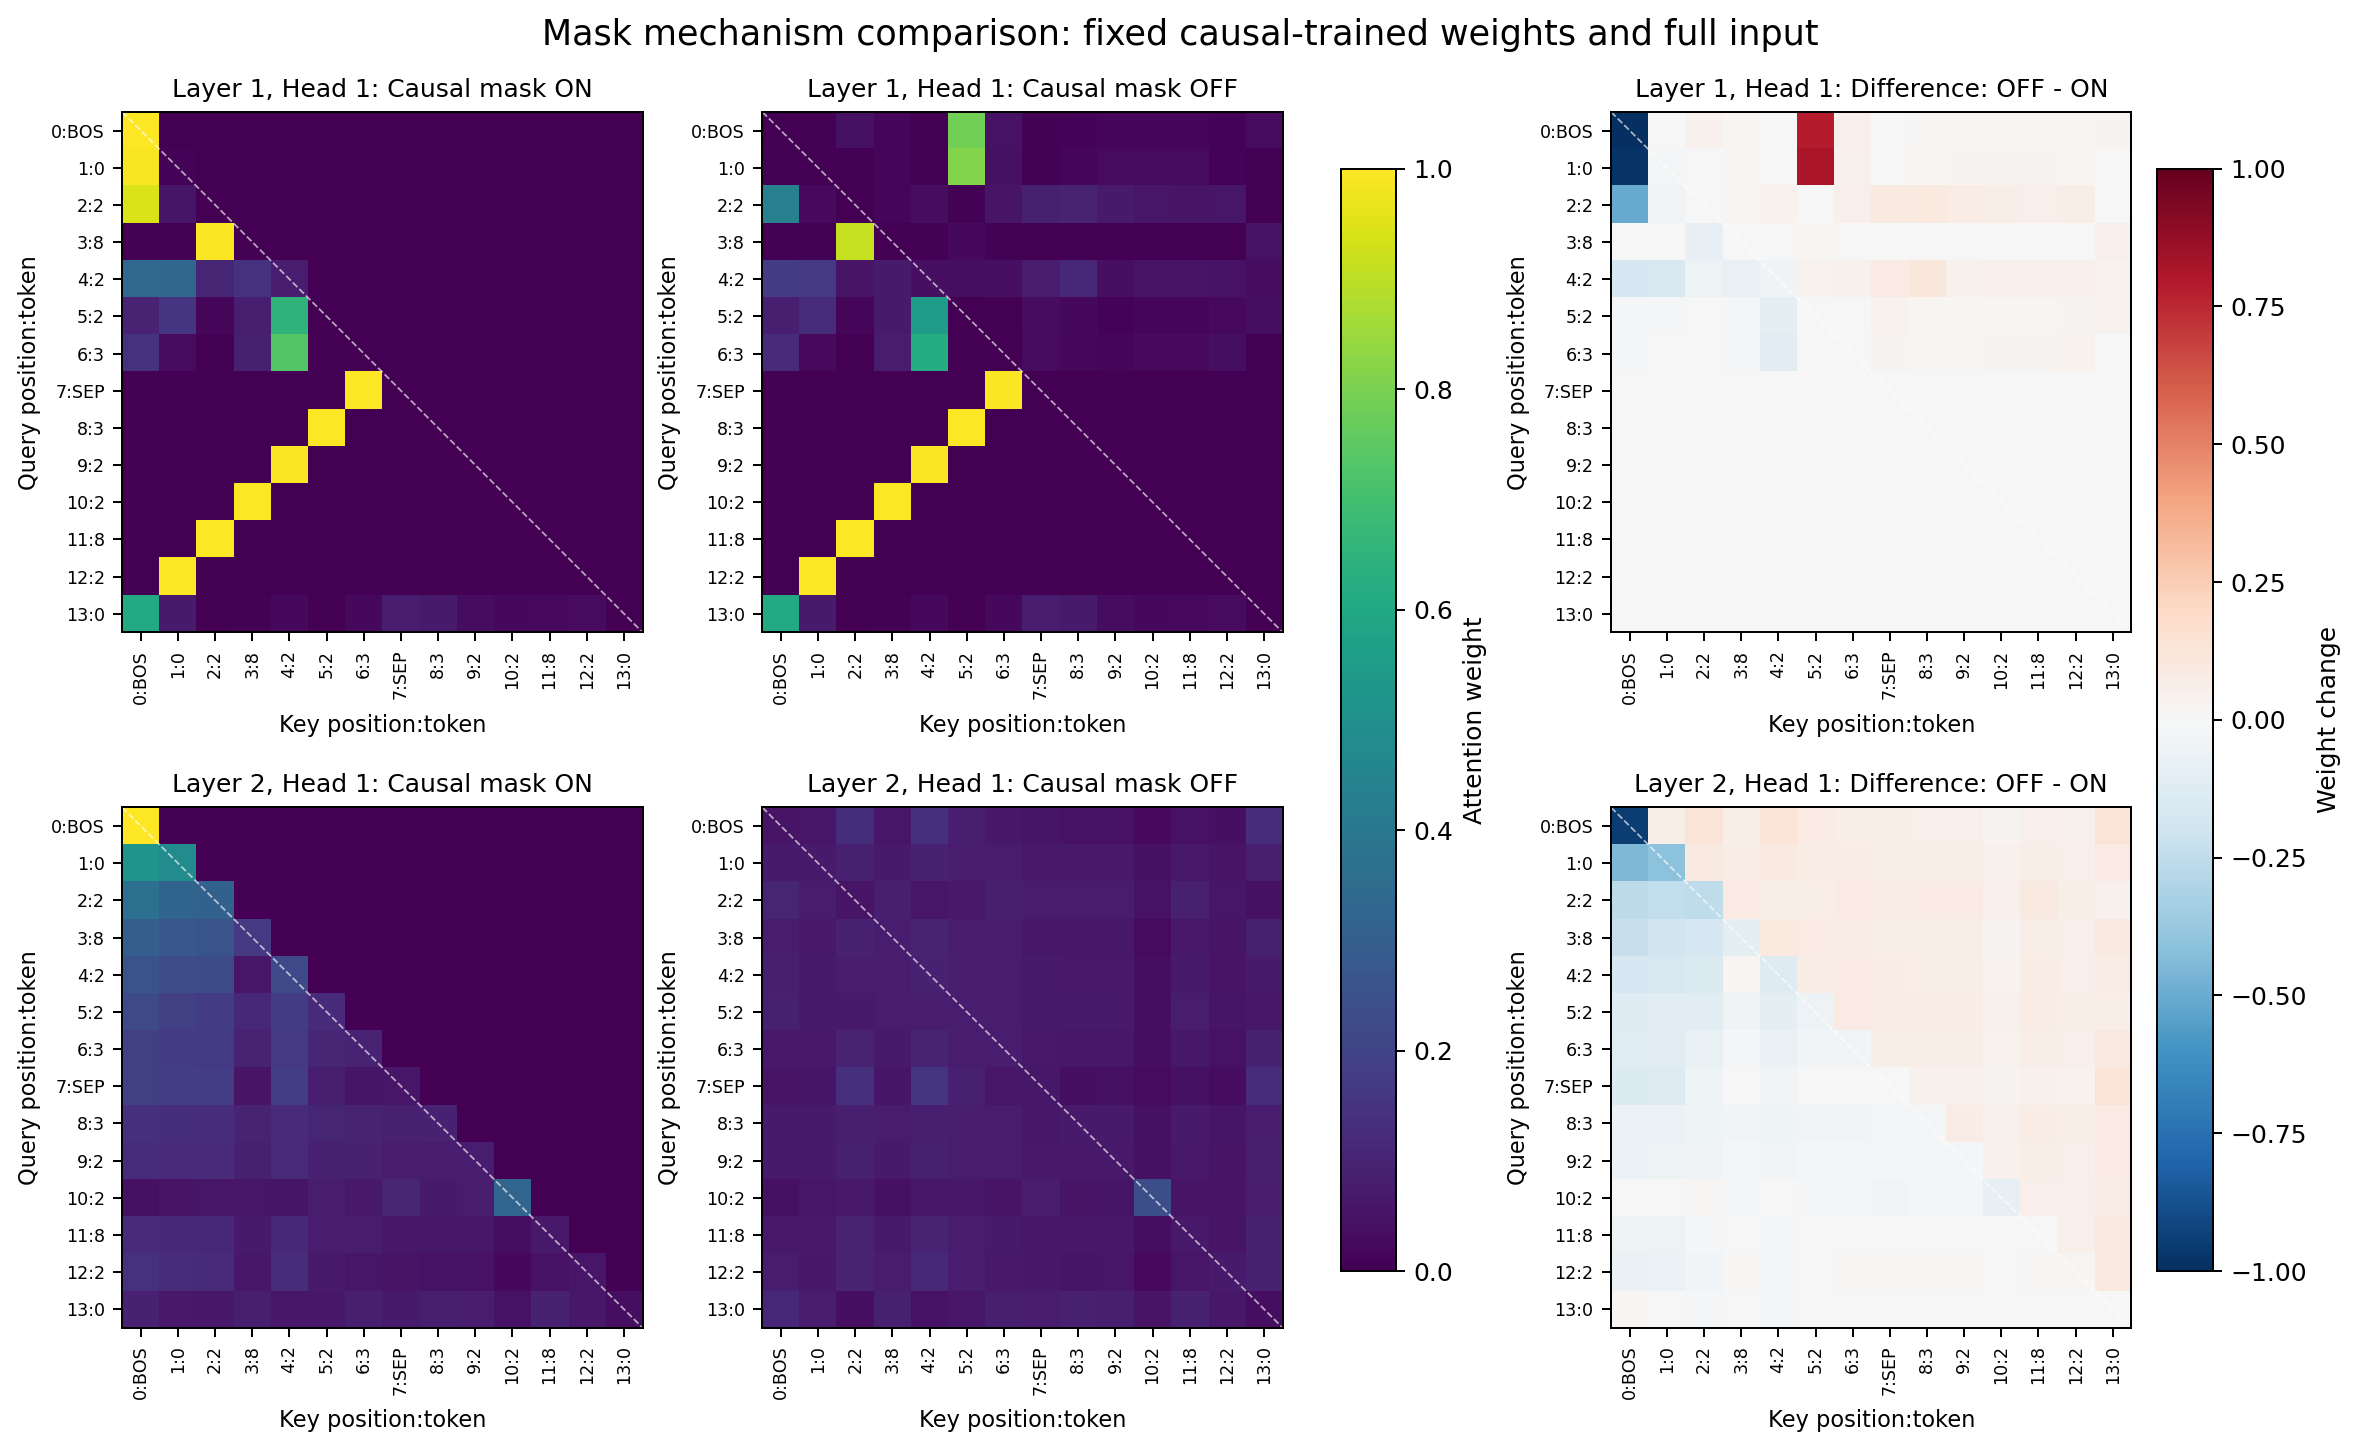
图 4:相同模型权重、相同教师强制输入下的 mask 开关对比。比较时固定每层第一个头,避免事后挑选最好看的头。
图 4 每行是一层的第一个头;左列开启 mask,中列关闭 mask,右列是“关闭减开启”。前两列的色标为 0–1,右列为 -1 到 1:红色表示权重增加,蓝色表示减少。这里的差值是注意力权重变化,不是 loss 变化;虚线标出 query/key 的同位置对角线。
关闭后,未来位置可以获得非零权重。为了进一步检验信息流,我们把输入中未来答案数字改掉,再观察题目前缀的 logits 是否变化:
| 同一权重的设置 | 未来扰动后的前缀最大变化 | 测试教师强制 loss | 整序列准确率 |
|---|---|---|---|
| mask 开启 | 0.000000 | 0.00024506 | 100% |
| mask 关闭 | 1.071323 | 0.00024725 | 100% |
表里的“前缀最大变化”比较的是输入位置 0–7 的 13 类原始 logits,取所有对应分数差值绝对值的最大值。1.071323 是分数变化,不是概率变化,更不是准确率下降 107%。
开启 mask 时前缀保持不变,关闭时发生变化,说明可见信息范围确实改变了。这个检查比“看起来像三角形”更能发现实现错误。
但这里的独立生成准确率仍然是 100%。观察到的信息流变化,不必一定造成当前任务上的生成失败。
还要分清两个实验:固定训练好的权重临时关 mask,与从初始化开始就不使用 mask 训练,不是同一个干预。后者放在下一节单独比较。
十二、消融:三组都 100%,还学到了什么
12.1 控制住其他变量,再改变头数或 mask
我们从头训练三组模型。无 mask 组是刻意去掉因果约束的对照,不能把它的教师强制训练方式当作标准因果语言模型的训练方式:
| 配置 | 头数 | 每头维度 | 训练与生成时的因果 mask |
|---|---|---|---|
| 完整模型 | 4 | 16 | 开启 |
| 单头模型 | 1 | 64 | 开启 |
| 无 mask 模型 | 4 | 16 | 关闭 |
每组隐藏维度都为 64,Q/K/V 和输出投影矩阵的尺寸没有改变,所以参数量都为 69,709。单头消融改变了注意力的组织方式,没有把整个模型缩小成原来的四分之一。
三组从相同种子和数值相同的初始参数出发,使用相同的数据、训练索引、600 步预算、优化器设置及评估函数。选择最后一步模型,不根据测试集结果挑最好的检查点。
12.2 真实结果
| 模型 | 参数量 | 步数 | 测试教师强制 loss | 数字准确率 | 整序列准确率 | 训练时间,秒 |
|---|---|---|---|---|---|---|
| 完整模型 | 69,709 | 600 | 0.00024506 | 100% | 100% | 11.021 |
| 单头模型 | 69,709 | 600 | 0.00025675 | 100% | 100% | 4.672 |
| 无 mask 模型 | 69,709 | 600 | 0.00023230 | 100% | 100% | 4.618 |
训练时间是本次单次墙钟测量,包含完整数据评估及检查点保存,受运行环境影响。不能把这三条数值直接解释为单头或无 mask “稳定快了几倍”。
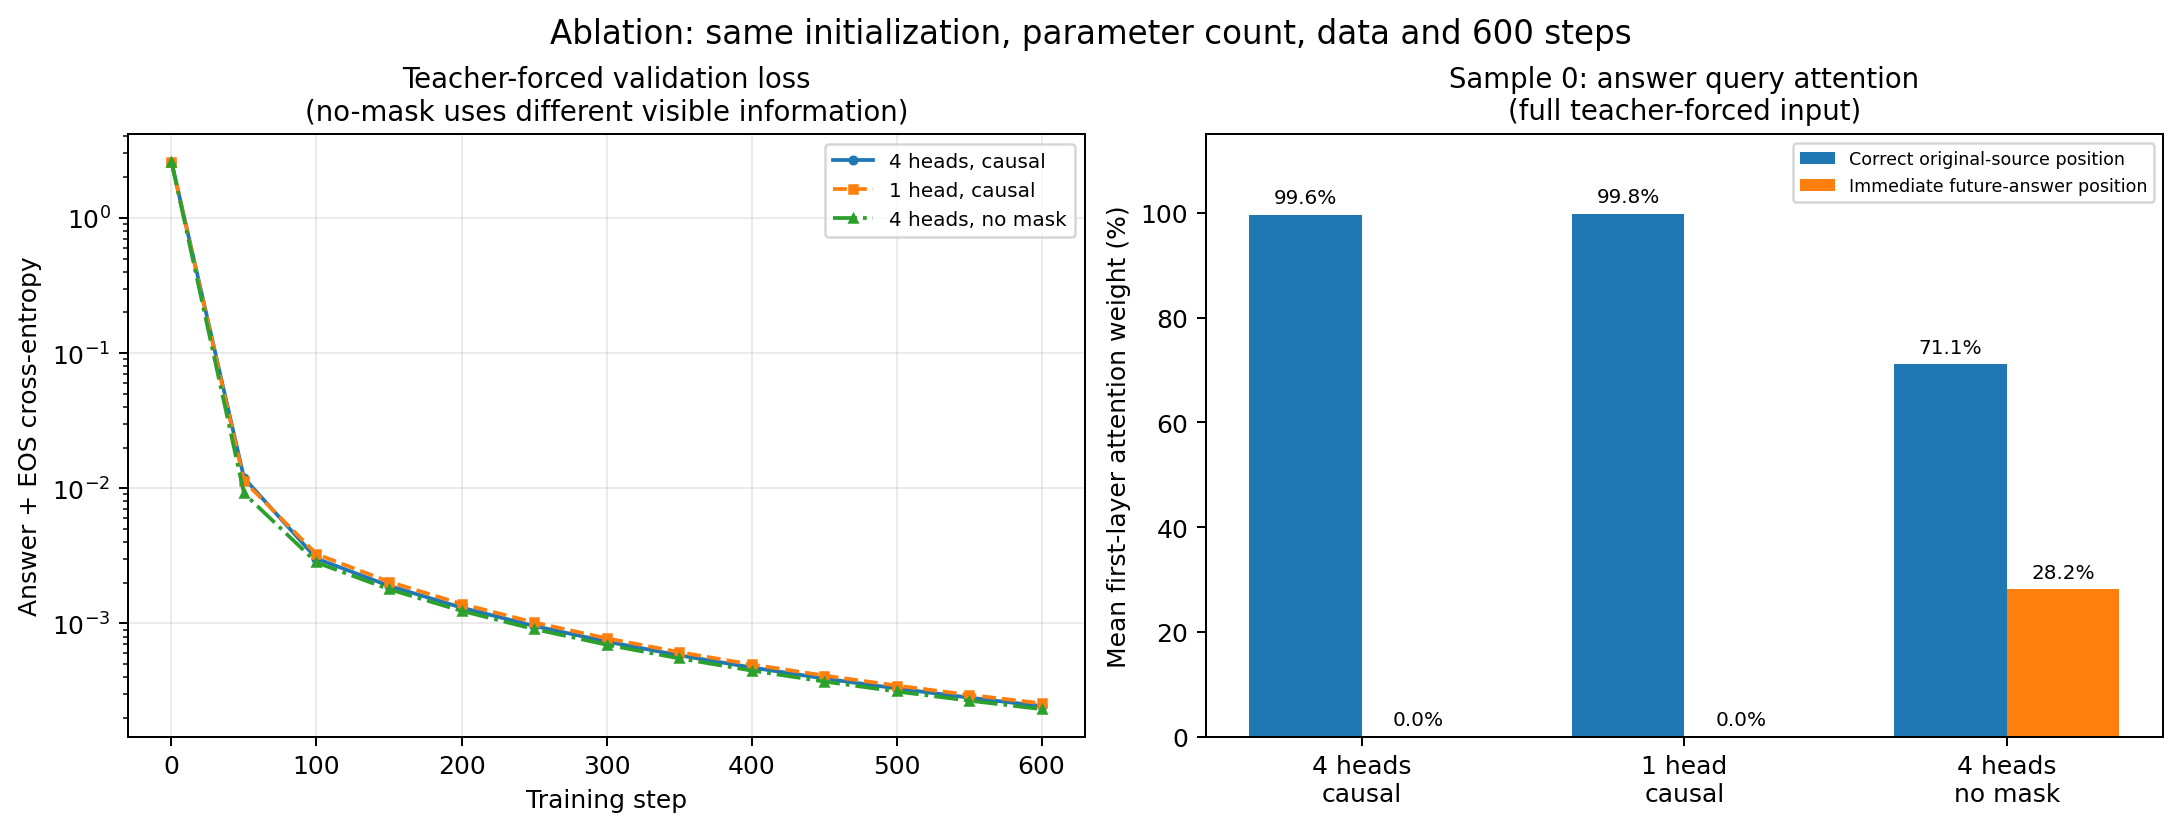
图 5:左侧为三组验证 loss;右侧为样本 0 第一层对原题目标位置及紧邻未来答案位置的平均注意力。右图在完整教师强制输入下提取,是权重统计,不是生成准确率。
当前任务出现了准确率饱和:三组都正确生成 512 条答案。我们不能根据这一次结果断言四头比单头更好,也没有观察到无 mask 必然生成失败。
这份结果的价值,在于让我们学会把不同证据分别解释,而不是预先认定消融一定要“掉分”。
12.3 为什么无 mask 的 loss 最低,却不能据此宣布它最好
教师强制输入中,答案数字本来就在后续位置上。对于六个数字预测,有:
第 i 个输入位置的标签 y[i],正好出现在下一个输入位置 x[i+1]。
关闭 mask 后,当前位置能直接读取这份未来答案。最后的 EOS 没有放进训练输入,因此这条直接泄漏路径主要对应六个数字目标,而不是 EOS。
两种模型计算的教师强制 loss 使用了不同的信息条件。比较这两个 loss,不能像比较两台看同一份试卷的模型那样直接排名。
样本 0 中,无 mask 模型第一层对正确原题位置的平均权重为 71.13%,对紧邻未来答案位置为 28.16%。它确实读取了未来答案信息,但仍保留了读取原题的信息路径。
到真正生成时,我们只输入题目,尚未生成的未来答案并不存在。即使关闭 mask,模型也不能读取一个根本没有输入的 token。本次无 mask 模型仍然成功生成全部测试样本,说明“训练时能泄漏答案”与“测试时一定失败”不是等价命题。
这也不证明这类训练方式可靠。短序列反转只有一套固定位置规则,结果不能代替更长序列、其他数据分布或其他随机种子的检验。对于模型究竟依赖哪些路径,我们保留证据边界,不把单张热图当作完整因果解释。
十三、常见错误可以按这张表排查
| 现象 | 优先检查 |
|---|---|
| 形状报错,无法拆头 | d_model % num_heads == 0;reshape 与 transpose 的顺序 |
| 注意力每行和不为 1 | softmax 是否沿 key 维;是否在 softmax 后才清零未来权重 |
| 出现 NaN | 是否有整行都被屏蔽;loss、梯度是否有限 |
| 训练 loss 很低,生成却错误 | 是否把标准答案带入了测试输入;是否忘记因果 mask |
| 第一个答案错位 | 应当取 SEP 所在位置的输出,即训练 query 7 |
| 生成第一步正确,后续不对 | 每一步是否将预测 token 追加到输入;是否始终取最后位置 |
| 六个数字都对,整序列仍不对 | EOS 是否在第七个输出;有没有提前结束 |
| 改未来 token 竟然改变因果前缀 | 所有层是否都传入 mask;上三角方向是否写反 |
| 两组消融看似同设置,结果不可比 | 初始化、数据划分、每步抽样、步数和评估口径是否一致 |
| 热图与任务对不上 | query 是预测当前位置还是下一位置;重复数字是否按位置区分 |
这些问题里,相当一部分在正式训练前就能检查。先跑形状、归一化、因果性和小批次反向传播检查,通常比发现结果异常后反复增加训练步数更有效。
十四、在 Colab 里怎样对照学习
下载上面的 notebook 后,上传到 Colab。运行时优先选择 GPU;没有 GPU 也可以用 CPU。Notebook 会检测设备,CPU 默认 300 步,GPU 默认 600 步;如果测速表明训练过慢,会统一降低所有组的训练预算。
建议按下面的顺序停下来观察,而不是立刻把所有输出滑过去:
- 数据构造后: 手工核对一条样本,数清 14 个输入位置与 7 个有效标签。
- 手写注意力后: 打印 Q/K/V、注意力矩阵与拼接输出的形状,检查未来权重。
- 完整模型后: 观察两层独立参数,确认一次反向传播能正常更新参数。
- 训练后: 同时读训练和验证曲线,再只给题目做逐 token 生成。
- 可视化后: 沿
query 7→key 6找到第一个答案的读取位置,再追踪后五个。 - 消融后: 把教师强制 loss、生成准确率和注意力变化分别写成一句话。
随文 notebook 保留了原始实跑代码和输出,没有为了博客改写训练实现。最后的整包导出可能较慢;学习模型本身时,可先完成到报告生成单元。实验文件保存在 Colab 临时运行目录 /content/experiment1_outputs,需要保留的产物应及时下载。
还有两个辅助文件可供对照:
它们记录的是本文这次 T4、600 步运行。CPU 改用较少步数后,结果可能不同,不应把文中的最终数值当作每次运行都必须逐位相同的标准答案。
十五、读完后,尝试独立回答这些问题
这些是理解检查,不要求再增加训练:
- 为什么输入位置 7 的 SEP,恰好负责预测第一个答案数字?
- 如果只设置
ignore_index=-100,为什么仍可能泄漏未来答案? - 为什么
softmax(dim=-1)的最后一维是 key,而不是 query? - 四头与单头参数量相同,实际改变的是什么?
- 某个题目位置没有直接分类 loss,它的 embedding 为什么仍然能获得梯度?
- 第二层没有清楚的反对角线,为什么不能认定它没有作用?
- 无 mask 模型生成 100%,为什么不能据此删除自回归训练里的因果约束?
- 为什么六个数字全对,还需要单独检查 EOS?
如果能用一条具体样本解释前四个问题,再用本次图表解释后四个问题,注意力公式、训练目标和生成过程之间的关系就基本连起来了。
参考资料与实验材料
本文的训练数值、预测、图表来自本次数字反转实验;机制说明结合以下原始论文与官方文档。原始 Transformer 论文中的完整结构与本文两层 decoder-only、Pre-LN 的教学实现并不完全相同。
- Vaswani et al., Attention Is All You Need,2017。
- Xiong et al., On Layer Normalization in the Transformer Architecture,2020。
- PyTorch 2.11:CrossEntropyLoss、LayerNorm、Module.eval。
随文 notebook 由实验一第 24 组的最终实跑版本原样复制,配图及 CSV 沿用同一轮最终记录。